本地识别
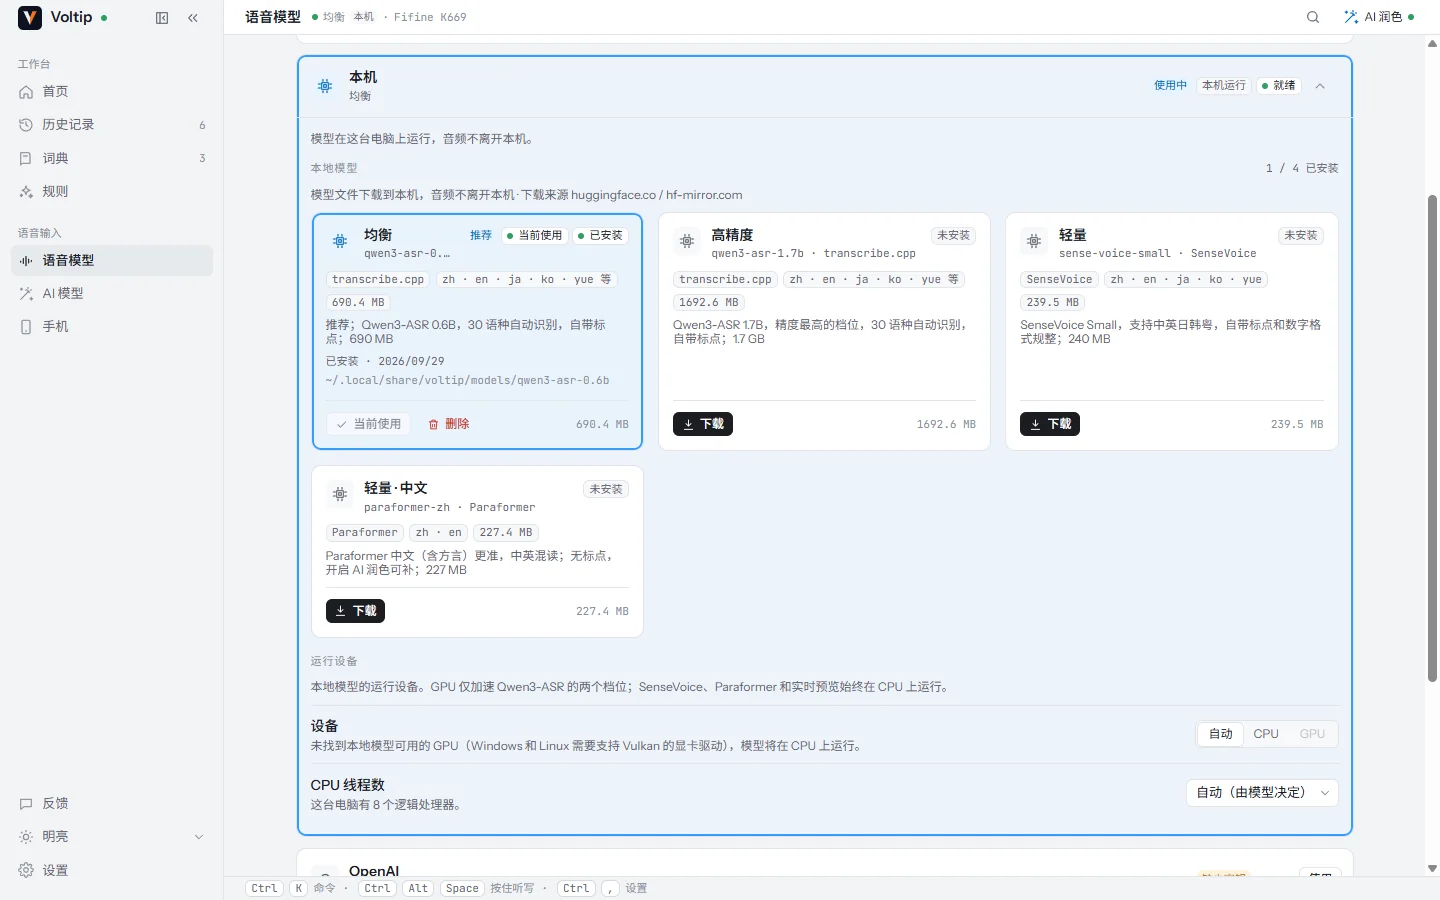
使用本地模型时,录音在这台电脑上完成识别,音频不会离开本机。在侧栏打开「语音模型」,选择「本机」,下载一个模型即可。
模型
| 模型 | 大小 | 语言 | 运行设备 | 说明 |
|---|---|---|---|---|
| Qwen3-ASR 0.6B | 690 MB | 30 种语言,自动识别 | GPU 或 CPU | 推荐。自带标点 |
| Qwen3-ASR 1.7B | 1.7 GB | 30 种语言,自动识别 | GPU 或 CPU | 最准确,速度较慢。与内置服务使用的是同一个模型 |
| SenseVoice Small | 240 MB | 中文、英文、日文、韩文、粤语 | CPU | 体积最小。自带标点,并规整数字写法 |
| Paraformer | 227 MB | 中文(含方言)与英文混说 | CPU | 中文识别更准。不带标点,开启 AI 润色可以补上 |
| 实时识别 | 169 MB | 中文与英文 | CPU | 边说边显示文字。最终文本仍由上面选用的模型识别 |
「语音模型」页「识别设置」中的「语言」,会传给支持指定语言的模型和服务;Qwen3-ASR 始终自动识别语言。
开启「静音裁剪」后,一个 1.8 MB 的静音检测模型会随第一个本地模型一起下载。
下载
- 正式版安装包先从项目自己的镜像下载,然后依次尝试 Hugging Face 和 hf-mirror.com。某个来源速度过慢或无法访问时,Voltip 会自动换到下一个。
- 下载中断后,会从中断处继续。
- 每个文件在使用前都会校验 SHA-256。
- 开始下载前,Voltip 会检查磁盘剩余空间是否足够。
模型保存在 Voltip 数据目录下的 models 目录中(数据目录的位置)。在「语音模型」页删除模型会同时删除它的文件。
CPU 与 GPU
在「本机」下,「运行设备」提供三个选项:
- 自动(默认):这台电脑有 Voltip 可用的显卡时使用显卡,否则使用处理器。
- CPU:始终使用处理器,可以通过「CPU 线程数」设置使用的线程数。
- GPU:使用显卡;有多块显卡时可以选择其中一块。
只有两个 Qwen3-ASR 模型会使用显卡:Windows 和 Linux 上通过 Vulkan,需要显卡驱动支持 Vulkan;Mac 上通过 Metal。SenseVoice、Paraformer 和实时识别模型始终在处理器上运行。显卡无法使用时,Voltip 会改用处理器,听写不受影响。
第一次在显卡上运行需要更长时间,因为驱动要为这个模型做一次准备:在我们的实测中,NVIDIA L40S 上约 13 秒,Tesla T4 上约 2 分钟。之后的运行启动很快。
实测数据
Qwen3-ASR 0.6B 识别一段 16 秒的中文语音(首次运行之后):
| 电脑 | 设备 | 加载 | 识别 |
|---|---|---|---|
| Linux,NVIDIA L40S | GPU(Vulkan) | 0.58 秒 | 0.16 秒 |
| Linux,同一台电脑 | CPU,8 个线程 | — | 2.87 秒 |
| Windows,NVIDIA Tesla T4 | GPU(Vulkan) | 1.6 秒 | 0.28 秒 |
SenseVoice Small(int8)识别同一段录音用时 0.20 至 0.34 秒,测试机为 32 核服务器处理器,使用 4 个线程。
Voltip 启动时以及每次更改设置后,都会在后台加载选用的模型,因此第一次听写不需要等待加载。
处理器要求
在 x86 电脑上,Qwen3-ASR 需要支持 AVX2 的处理器:2013 年(Haswell)以后的 Intel 处理器,以及 2015 年以后的 AMD 处理器。在更早的处理器上,Voltip 会说明无法加载的原因,请改用 SenseVoice、Paraformer 或云端服务。使用 Apple 芯片的 Mac 原生运行这些模型。
中文字形
部分模型会把中文识别为繁体字。在「识别设置」的「中文字形」中,可以选择简体(默认)、繁体或保持原样。字形转换在识别之后立即进行,早于词典纠正。
命令行
这些模型也可以在不打开应用窗口的情况下使用,适合脚本和服务器:
voltip-desktop --list-models
voltip-desktop --download-model qwen3-asr-0.6b
voltip-desktop --transcribe-file sample.wav --json
voltip-desktop --list-compute全部选项见命令行。